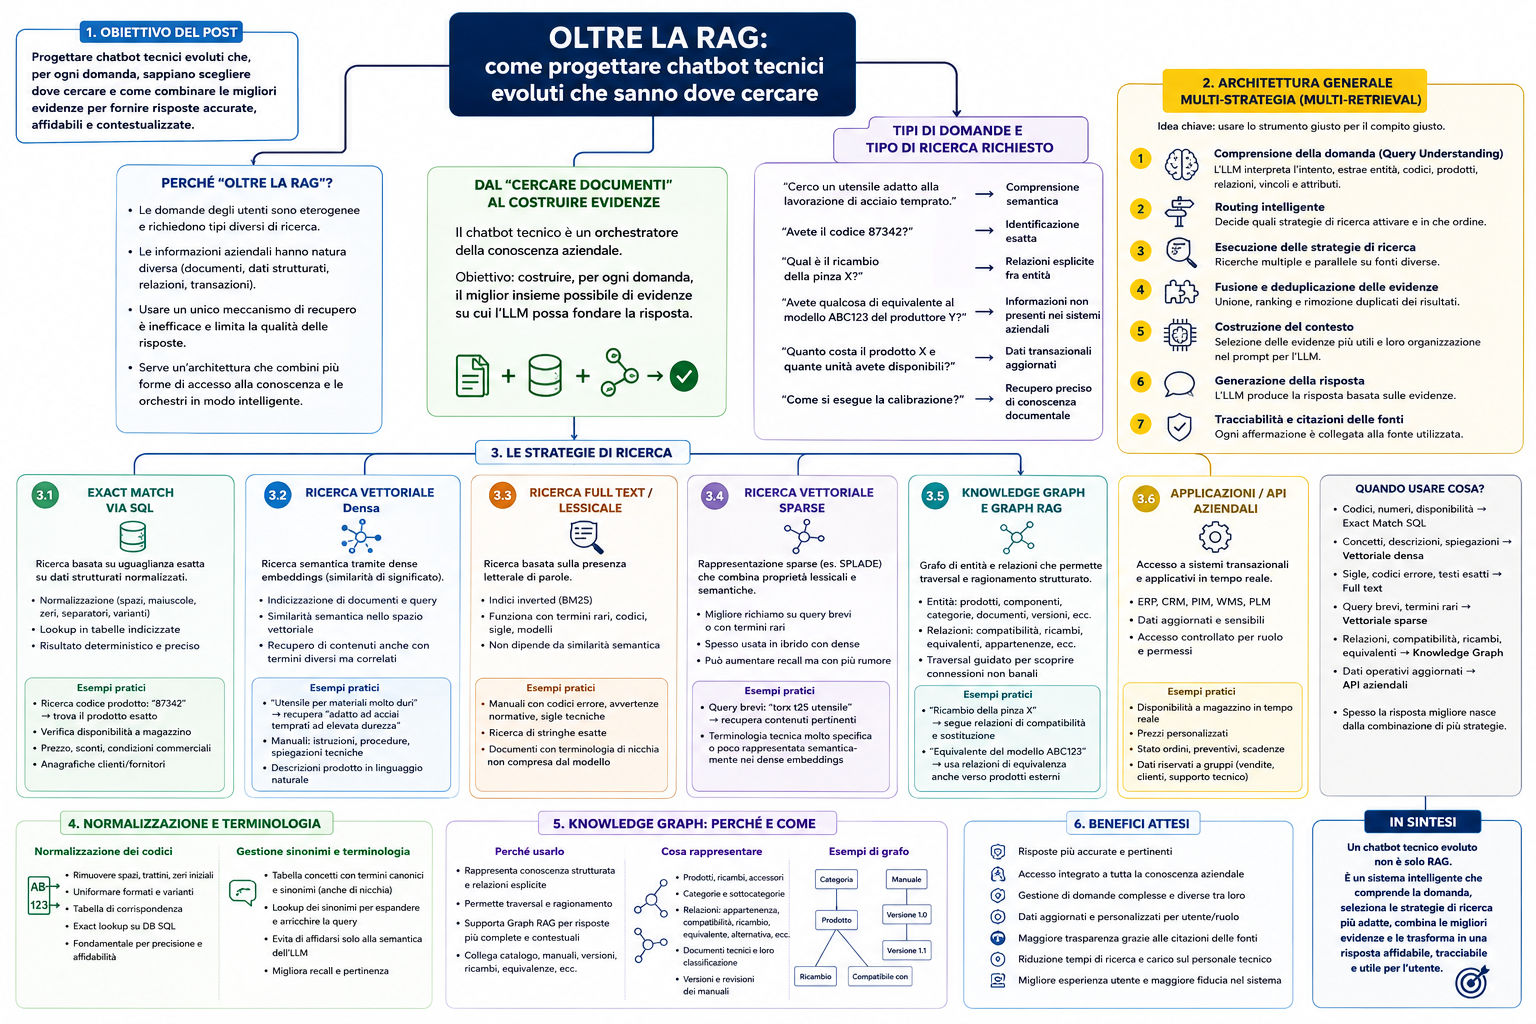
Un chatbot tecnico evoluto non dovrebbe cercare tutte le risposte nello stesso modo.
Comprendere una richiesta espressa in linguaggio naturale, identificare con precisione un codice prodotto, trovare una norma o un valore numerico, conoscere prezzo e disponibilità aggiornati, individuare un ricambio, seguire una relazione di compatibilità o confrontare un prodotto con quello di un concorrente sono problemi diversi, che richiedono strumenti diversi.
Nel post analizziamo come combinare ricerca vettoriale semantica, full-text search, normalizzazione ed exact matching dei codici, SQL e API, Web Grounding, Knowledge Graph e Graph RAG, reranking e Cache-Augmented Generation.
Il punto centrale è passare dal semplice “cercare documenti” alla costruzione delle migliori evidenze disponibili per quella specifica domanda.
L’LLM rimane fondamentale per comprendere la richiesta e formulare la risposta. Ma l’affidabilità del chatbot dipende soprattutto da ciò che avviene prima: riconoscere entità e intenti, scegliere le fonti corrette, attraversare relazioni, recuperare dati aggiornati, gestire provenance e conflitti e costruire un context window pertinente e governato.
In altre parole, la vera domanda non è soltanto:
“Quanto è intelligente il modello?”
ma:
“Quanto è intelligente il sistema con cui gli permettiamo di accedere alla conoscenza aziendale?”
***
Quando si parla di chatbot aziendali basati su documentazione tecnica, cataloghi prodotto, manuali di istruzioni e product data, il termine RAG – Retrieval-Augmented Generation viene spesso utilizzato come se identificasse l’intera architettura dell’applicazione.
La logica di base è nota: prima di formulare una risposta, il sistema ricerca nei contenuti aziendali le informazioni pertinenti alla domanda dell’utente e le fornisce al Large Language Model (LLM) come contesto. In questo modo il modello non si basa soltanto sulla propria conoscenza generale, ma fonda la risposta sulle fonti informative validate dall’azienda.
Per molte applicazioni questo costituisce un enorme passo avanti. Ma per un chatbot tecnico evoluto può non bastare.
Il motivo è semplice: le domande degli utenti non richiedono tutte lo stesso tipo di ricerca e le informazioni aziendali non hanno tutte la stessa natura.
Una domanda può richiedere di capire il significato di una descrizione tecnica. Un’altra di individuare esattamente un codice. Una terza di conoscere la disponibilità attuale di un prodotto. Un’altra ancora di stabilire quale ricambio sia associato a un componente, oppure quale articolo del nostro catalogo possa essere equivalente a quello di un concorrente che nei nostri sistemi non è mai stato censito.
Trattare tutti questi problemi con un unico meccanismo di recupero delle informazioni significa chiedere alla tecnologia di fare qualcosa per cui non è stata progettata.
L’architettura più adatta è quindi un’altra: combinare forme differenti di accesso alla conoscenza e fare in modo che il sistema sappia scegliere, per ogni domanda, quali utilizzare e come combinare i risultati.
Il punto centrale non è più semplicemente costruire un sistema RAG. È costruire un sistema capace di assemblare, per ogni domanda, il miglior insieme possibile di evidenze su cui l’LLM possa fondare la risposta.
Dal “cercare documenti” al costruire evidenze
In un chatbot tecnico il modello linguistico svolge almeno due funzioni importanti.
Deve comprendere ciò che l’utente vuole ottenere, anche quando la domanda è formulata con terminologia non coincidente con quella utilizzata nei cataloghi o nei manuali.
E deve poi trasformare le informazioni recuperate in una risposta linguisticamente chiara e coerente.
Ma fra questi due momenti si trova la parte più delicata dell’architettura: decidere dove cercare e che cosa recuperare.
Supponiamo che un distributore industriale disponga di migliaia di prodotti, cataloghi tecnici, manuali, FAQ, tabelle di compatibilità, dati ERP e informazioni commerciali.
L’utente potrebbe chiedere:
“Cerco un utensile adatto alla lavorazione di acciaio temprato.”
“Avete il codice 87342?”
“Qual è il ricambio della pinza X?”
“Avete qualcosa di equivalente al modello ABC123 del produttore Y?”
“Quanto costa il prodotto X e quante unità avete disponibili?”
“Come si esegue la calibrazione?”
Sono tutte domande rivolte allo stesso chatbot.
Ma sarebbe un errore pensare che debbano essere risolte tutte interrogando nello stesso modo lo stesso database.
La prima richiede soprattutto comprensione semantica.
La seconda richiede identificazione esatta.
La terza richiede una relazione esplicita fra entità (prodotti, nel nostro caso).
La quarta può richiedere informazioni che l’azienda non possiede ancora.
La quinta richiede dati transazionali aggiornati, il cui accesso potrebbe essere riservato a determinati gruppi di utenti (per esempio forza vendita, clienti).
La sesta richiede il recupero preciso di conoscenza documentale.
Un chatbot tecnico evoluto deve quindi diventare una sorta di orchestratore della conoscenza aziendale.
Primo livello: ricerca semantica con vettori densi
La ricerca vettoriale basata su dense embeddings rappresenta uno dei fondamenti della RAG moderna.
Documenti, sezioni di manuale, descrizioni prodotto, FAQ e domanda dell’utente vengono rappresentati matematicamente all’interno di uno spazio vettoriale.
La ricerca non dipende quindi soltanto dalla presenza delle medesime parole, ma dalla prossimità semantica fra la domanda e i contenuti. Il sistema ricerca vicinanza di significato.
Se un utente scrive:
“Cerco una soluzione per lavorare materiali molto duri”
il documento pertinente potrebbe utilizzare invece espressioni come:
“adatto alla lavorazione di acciai temprati ad elevata durezza”.
Una ricerca puramente lessicale potrebbe non cogliere adeguatamente la relazione.
Una buona ricerca semantica può invece recuperare il contenuto perché riconosce la similarità concettuale fra i due testi.
Questo è il grande vantaggio della dense vector search: rende il chatbot capace di lavorare anche quando il linguaggio dell’utente e il linguaggio della documentazione aziendale non coincidono perfettamente.
È una caratteristica particolarmente importante nei contesti tecnici.
Gli utenti possono utilizzare sinonimi, denominazioni commerciali, gergo di officina, descrizioni funzionali oppure esprimere un problema senza conoscere il nome esatto del prodotto che potrebbe risolverlo.
Ma proprio perché lavora sulla similarità, la ricerca semantica ha anche un limite intrinseco: similarità non significa identità.
In un catalogo tecnico esistono moltissime situazioni in cui questa differenza è decisiva.
Secondo livello: ricerca lessicale, sparse retrieval ed exact matching
Un chatbot tecnico deve quindi affiancare alla ricerca semantica una modalità di ricerca maggiormente sensibile ai termini effettivamente presenti nei contenuti.
Qui è opportuno distinguere tecnologie diverse che vengono talvolta accomunate.
Una ricerca full-text tradizionale lavora sulla corrispondenza lessicale fra query e documenti.
Una ricerca basata su sparse representations utilizza invece rappresentazioni sparse pesate e può possedere caratteristiche più sofisticate, introducendo anche capacità semantiche.
Le due tecnologie non sono identiche.
Dal punto di vista architetturale, però, entrambe possono svolgere una funzione complementare rispetto alla dense search: dare maggior peso alla presenza di termini specifici.
Questo è particolarmente utile nella documentazione tecnica, dove una singola sigla può cambiare completamente il significato di una frase.
Pensiamo a norme, materiali, classi di precisione, denominazioni di componenti, codici di errore, unità di misura o abbreviazioni tecniche.
Ancora più particolare è il caso dei codici articolo.
Se l’utente inserisce “ABC-12345”, il problema non consiste innanzitutto nello stabilire quali documenti siano semanticamente simili a quella stringa.
Occorre determinare se ABC-12345 identifica esattamente un’entità conosciuta dal sistema.
Per questo, in un chatbot tecnico, alla semantic search e alla lexical search conviene affiancare veri meccanismi di exact matching e identity resolution.
Capire che cosa intende l’utente, riconoscere le parole che utilizza e identificare esattamente il codice che ha citato sono problemi differenti.
Ed è opportuno trattarli come tali.
Dense e lexical retrieval insieme: la ricerca ibrida
Dense vector search e ricerca lessicale non devono necessariamente competere.
Nella maggior parte dei sistemi tecnici possono essere utilizzate contemporaneamente.
La dense search recupera i contenuti semanticamente vicini alla domanda.
La lexical o sparse search recupera quelli che presentano le corrispondenze terminologiche più forti.
Si ottengono così due classifiche differenti.
A questo punto occorre combinarle.
Una possibilità è utilizzare tecniche di rank fusion, come Reciprocal Rank Fusion (RRF), che aggregano i ranking provenienti dai differenti sistemi di retrieval.
È importante distinguere questa operazione dal reranking.
La rank fusion risponde alla domanda:
“Come combino in un’unica graduatoria le classifiche prodotte da sistemi differenti?”
Il reranking risponde invece a una domanda successiva:
“Fra questi candidati, quali sono davvero i più pertinenti rispetto alla domanda dell’utente?”
L’architettura può quindi seguire una sequenza di questo tipo: dense retrieval + lexical/sparse retrieval → rank fusion → eventuale reranking → selezione dei contenuti migliori.
Il vantaggio della ricerca ibrida è evidente.
Il sistema può contemporaneamente comprendere che “lavorazione di materiali ad alta durezza” è semanticamente vicina a “lavorazione di acciai temprati” e attribuire un peso molto elevato alla presenza di una sigla, di una misura o di una denominazione tecnica richiesta espressamente dall’utente.
Non è necessario scegliere fra precisione lessicale e comprensione semantica.
È possibile utilizzarle insieme.
Reranking: non recuperare più contenuti, ma scegliere meglio
Nel RAG il problema non consiste soltanto nel recuperare contenuti potenzialmente pertinenti.
Occorre anche evitare di riempire il context window dell’LLM con informazioni marginali.
Il primo stadio di retrieval può quindi essere relativamente ampio. Dense search e lexical search producono un insieme di candidati.
Il reranker interviene successivamente per valutare con maggiore accuratezza la relazione fra query e singoli contenuti e selezionare quelli da utilizzare effettivamente.
Questa distinzione è importante anche dal punto di vista progettuale.
Il retrieval privilegia generalmente l’ampiezza del recupero (recall): evitare di perdere un contenuto potenzialmente importante.
Il reranking privilegia la precisone (precision): fare in modo che nel contesto finale arrivino soprattutto le evidenze più utili.
Il context window dovrebbe quindi il risultato di un’attività di context engineering.
Non tutti i dati devono diventare embedding
A questo punto emerge una distinzione essenziale.
Manuali, cataloghi, FAQ, procedure, schede tecniche, articoli di knowledge base e documentazione di prodotto hanno generalmente un certo grado di stabilità.
Sono quindi candidati naturali a indicizzazione, embedding e retrieval documentale.
Ma in azienda esistono anche dati di natura completamente diversa.
Prezzo.
Disponibilità.
Sconto applicabile.
Stato di un ordine.
Tempi aggiornati di consegna.
Condizioni commerciali dipendenti dal cliente.
Queste informazioni sono spesso già contenute in ERP, PIM, CRM o altri database relazionali.
Trasformarle periodicamente in documenti, indicizzarle e recuperarle attraverso similarità semantica è una scelta poco razionale, non perché un vector index non possa essere aggiornato, ma perché, quando la domanda richiede un valore strutturato, esatto e aggiornato, è preferibile interrogare direttamente il sistema che costituisce la fonte autorevole di quel dato.
Se l’ERP indica che la disponibilità del codice X è 17, il chatbot non deve ricercare un paragrafo “semanticamente vicino” alla domanda sulla disponibilità.
Deve recuperare il valore 17.
Questo porta a una distinzione fondamentale fra knowledge retrieval e operational data retrieval.
Il primo cerca conoscenza pertinente.
Il secondo recupera fatti strutturati dalla source of truth aziendale.
SQL e API come fonti di dati di fatto
Questa distinzione ha conseguenze importanti sull’architettura.
I contenuti ottenuti dalla RAG possono essere sottoposti a ranking e reranking perché il problema consiste nello stabilire quali siano più pertinenti rispetto alla domanda.
Un risultato SQL deterministico non richiede lo stesso trattamento.
Se la query identifica in modo univoco un prodotto e il database restituisce:
prezzo = 24,60 euro
stock = 17
quei valori non sono “candidati semanticamente pertinenti”. Sono dati di fatto strutturati restituiti dalla fonte competente.
Devono essere associati all’entità corretta, controllati dal punto di vista delle autorizzazioni e quindi forniti all’LLM, oppure direttamente all’applicazione, come dati strutturati.
Questa separazione consente inoltre di proteggere i sistemi gestionali.
Non è necessario interrogare continuamente l’ERP durante ogni conversazione.
La ricerca dei dati commerciali può essere attivata on demand, solo quando la domanda dell’utente la rende necessaria.
La modularità dei tool diventa quindi un fattore di affidabilità: identificazione dei codici, recupero dei product data e interrogazione di prezzo e disponibilità possono essere funzioni distinte, ciascuna con uno scopo, una fonte e proprie regole di autorizzazione.
Normalizzazione dei codici, exact match, ricerca semantica e ricerca lessicale: perché un chatbot tecnico ha bisogno di segnali diversi
Nei cataloghi tecnici e nei manuali di istruzioni convivono due tipi di informazione molto diversi.
Da una parte vi sono concetti e significati: applicazioni, funzioni, problemi, procedure, caratteristiche, modalità d’uso. In questi casi è importante che il chatbot sappia riconoscere contenuti pertinenti anche quando l’utente utilizza parole diverse da quelle presenti nella documentazione.
Dall’altra vi sono elementi per i quali conta invece la precisione della stringa: codici articolo, codici di errore, sigle, norme, numeri di modello, valori dimensionali, classi, parametri software, unità di misura.
Un’unica modalità di retrieval difficilmente eccelle in entrambi i compiti.
Per questo, in un chatbot tecnico evoluto, è utile distinguere almeno cinque capacità:
- normalizzazione degli identificatori
- exact matching su una fonte strutturata, per esempio un database SQL
- ricerca vettoriale densa, orientata alla similarità semantica
- ricerca full-text o lessicale, orientata alla corrispondenza dei termini
- eventualmente, ricerca vettoriale sparsa, che introduce un ulteriore segnale a metà strada fra precisione terminologica ed espansione semantica.
Queste capacità non sono necessariamente alternative. Risolvono problemi differenti e possono essere orchestrate in sequenza.
Normalizzare prima di cercare: il problema dei codici
Supponiamo che nel catalogo sia presente il codice:
AB-123
e che l’utente chieda:
“Avete a catalogo la lunghezza 10 della punta codice AB 123?”
Oppure che un manuale contenga:
X-Y-Z
e l’utente chieda:
“Che cosa significa il codice di errore XYZ?”
Dal punto di vista umano è evidente che AB-123 e AB 123 possono rappresentare lo stesso identificatore, così come X-Y-Z e XYZ.
Per un sistema informatico, però, sono stringhe differenti.
Affidare esclusivamente alla ricerca semantica il compito di stabilire se rappresentino la stessa entità sarebbe poco robusto. Un embedding è progettato principalmente per rappresentare il significato di un testo, non per garantire l’identità fra varianti ortografiche di un codice.
La prima operazione dovrebbe quindi essere la normalizzazione.
La normalizzazione consiste nell’applicare regole deterministiche che trasformano le diverse grafie ammesse di uno stesso identificatore in una rappresentazione canonica destinata alla ricerca.
Per esempio:
AB-123 → AB123
AB 123 → AB123
ab-123 → AB123
e:
X-Y-Z → XYZ
X Y Z → XYZ
Il codice originale non viene eliminato: continua a essere utilizzato per la visualizzazione e nelle fonti documentali. Viene semplicemente affiancato da una forma normalizzata.
Si possono quindi memorizzare, per esempio:
code_original = AB-123
code_normalized = AB123
La stessa funzione di normalizzazione deve essere applicata anche alla query dell’utente.
In questo modo, quando l’utente scrive AB 123, il sistema non confronta direttamente:
AB 123 con AB-123
ma:
normalize(AB 123) con normalize(AB-123)
ottenendo in entrambi i casi:
AB123.
La normalizzazione è deterministica, non semantica
Questo aspetto è importante.
La normalizzazione non significa chiedere all’LLM:
“Secondo te questi due codici indicano probabilmente lo stesso prodotto?”
Significa applicare regole definite a priori.
Per esempio:
- conversione in maiuscolo
- eliminazione degli spazi
- eliminazione di alcuni separatori
- normalizzazione di prefissi
- eventuale gestione di formati ricorrenti.
Le regole devono però essere progettate sulla base del dominio.
Non sarebbe corretto stabilire genericamente che tutti i trattini o tutti gli spazi sono sempre irrilevanti. In alcune famiglie di codici il separatore potrebbe avere significato e la sua eliminazione potrebbe generare collisioni fra identificatori realmente differenti.
La normalizzazione va quindi definita per tipologia di identificatore: codice prodotto, codice ricambio, codice fornitore, modello macchina, codice errore, parametro e così via.
È inoltre importante distinguere la normalizzazione dalla correzione di un errore.
AB 123 invece di AB-123 può essere una semplice variante grafica.
AB-132 invece di AB-123 è un’altra cosa: potrebbe essere un errore di digitazione, ma potrebbe anche essere un codice realmente esistente.
Nel primo caso posso normalizzare deterministicamente.
Nel secondo posso eventualmente proporre un candidato tramite fuzzy matching, ma devo trattarlo come ipotesi, non come identità certa.
Dove avviene la normalizzazione
La normalizzazione dovrebbe essere applicata in due momenti complementari.
Il primo è la fase di ingestion.
Quando vengono acquisiti cataloghi, manuali, product data e altri contenuti, i codici rilevanti vengono estratti e associati alla loro forma canonica.
Per esempio:
AB-123 → AB123
oppure:
X-Y-Z → XYZ.
Questa informazione può essere memorizzata in un database strutturato dedicato all’identity resolution.
Il secondo momento è la query.
Quando l’utente formula una domanda, il sistema identifica eventuali stringhe che possono rappresentare un codice, applica la stessa funzione di normalizzazione e interroga il database.
La regola fondamentale è che ingestion e query utilizzino lo stesso meccanismo di normalizzazione.
Exact matching: stabilire di quale entità si parla
Dopo la normalizzazione può intervenire l’exact matching.
Supponiamo di avere nel database:
code_normalized = AB123
e che dalla domanda dell’utente sia stato ricavato:
AB123.
La query può verificare:
code_normalized = ‘AB123’
e restituire il prodotto canonico:
AB-123.
In questo momento non stiamo ancora cercando “documenti pertinenti”.
Stiamo risolvendo un problema di identità:
Di quale prodotto, componente, modello o errore sta parlando l’utente?
Questa distinzione è essenziale.
L’exact matching risponde principalmente alla domanda:
“È esattamente questa entità?”
La ricerca documentale risponde invece a:
“Quali contenuti sono pertinenti rispetto a ciò che l’utente vuole sapere su questa entità?”
Una volta identificato AB-123, il chatbot può quindi cercare nella documentazione ciò che riguarda la “lunghezza 10”, evitando di lasciare al motore semantico il compito di stabilire contemporaneamente sia l’identità del prodotto sia l’informazione richiesta.
Exact matching e full-text non sono la stessa cosa
Questa distinzione merita di essere esplicitata.
Con l’exact matching, dopo la normalizzazione, la domanda è sostanzialmente:
Esiste l’identificatore AB123?
L’output tipico è:
- una determinata entità
- eventualmente più entità da disambiguare
- oppure nessun risultato.
Con una full-text search, invece, il sistema riceve termini come:
punta, lunghezza, 10, AB, 123
e cerca i documenti nei quali questi termini risultano maggiormente rilevanti.
L’output non è normalmente una semplice risposta sì/no.
È una classifica di contenuti.
Potremmo ottenere:
Documento A → score elevato
Documento B → score medio
Documento C → score inferiore.
La full-text search risponde quindi alla domanda:
“Quali testi contengono o rappresentano meglio questi termini?”
Non:
“Quale entità è esattamente quella indicata?”
Questo spiega perché exact matching e full-text search sono complementari.
Ricerca vettoriale densa: cercare per significato
Una volta risolta l’identità, rimane il problema di comprendere che cosa vuole sapere l’utente.
È qui che la dense vector search diventa particolarmente efficace.
La domanda e i contenuti vengono rappresentati tramite embedding densi all’interno di uno spazio vettoriale.
Il retrieval avviene sulla base della similarità fra queste rappresentazioni.
Il vantaggio fondamentale è che non è necessario che utente e documentazione utilizzino le stesse parole.
Per esempio, l’utente potrebbe chiedere:
“Cerco una punta per lavorare inox.”
Il catalogo potrebbe invece riportare:
“Indicata per la lavorazione di acciai inossidabili.”
Oppure:
“Quale utensile posso utilizzare su materiale molto duro?”
mentre la documentazione parla di:
“lavorazioni su acciai temprati ad elevata durezza”.
La ricerca semantica può recuperare correttamente questi contenuti perché riconosce una vicinanza di significato anche in assenza di corrispondenza terminologica perfetta.
Questo è particolarmente utile nei cataloghi tecnici, dove gli utenti possono utilizzare:
- sinonimi
- denominazioni funzionali
- gergo professionale
- descrizioni del problema
- terminologia meno specialistica di quella adottata dal produttore
- formulazioni molto differenti da quelle presenti nella documentazione.
La dense search risponde alla domanda:
“Quali contenuti esprimono concettualmente ciò che l’utente sta cercando?”
Il limite della ricerca semantica: significato e precisione non coincidono
La capacità di generalizzare semanticamente è anche il motivo per cui la dense search non dovrebbe essere l’unico meccanismo di retrieval nei corpora tecnici.
Consideriamo:
10 mm
12 mm
DIN 3113
DIN 3110
IP67
IP65
P27
P72
120 Nm
102 Nm.
Semanticamente, alcune di queste stringhe possono essere molto vicine.
Tecnicamente, però, possono indicare prodotti, condizioni o requisiti completamente differenti.
In questi casi è importante preservare il segnale lessicale.
Ed è qui che la full-text search aggiunge valore.
Full-text / lexical search: quando contano proprio quelle parole
Una ricerca full-text tradizionale lavora sulla presenza e sul peso dei termini nella query e nei documenti.
Il suo valore nei cataloghi e nei manuali tecnici è particolarmente elevato quando la query contiene elementi per i quali la corrispondenza testuale possiede un forte significato.
Per esempio:
- codici e part number
- norme
- sigle
- classi
- diametri
- coppie di serraggio
- tensioni
- codici di errore
- parametri
- nomi esatti di funzioni
- denominazioni tecniche rare
- valori numerici
- unità di misura
- messaggi di diagnostica.
Supponiamo che l’utente chieda:
“Cerco una chiave conforme a DIN 3113.”
La presenza esatta di DIN 3113 nella documentazione costituisce un segnale fortissimo.
Oppure:
“Il manuale riporta una coppia di 120 Nm?”
Qui 120 Nm non è semplicemente un concetto semanticamente simile ad altri valori di coppia. È il valore richiesto.
La lexical search è quindi molto utile per controbilanciare la capacità della dense search di generalizzare.
Exact match, dense e full-text retrival insieme
I due retrieval rispondono a domande differenti.
La dense search chiede:
“Quali contenuti hanno un significato vicino alla query?”
La full-text chiede:
“Quali contenuti corrispondono maggiormente ai termini utilizzati?”
Per questo la loro combinazione è particolarmente efficace nei corpora tecnici.
Supponiamo che l’utente chieda:
“Punta AB123 da 10 mm per inox.”
Dopo l’exact match abbiamo già determinato che AB123 corrisponde al prodotto AB-123.
La ricerca lessicale può dare molto peso a:
10 mm
e ad eventuali corrispondenze precise.
La ricerca semantica può invece comprendere:
inox ↔ acciaio inossidabile.
Il sistema ottiene quindi contemporaneamente:
precisione sull’identificatore e sui valori
comprensione del significato della richiesta.
Un esempio tratto da un manuale tecnico
Consideriamo:
“La macchina segnala X Y Z quando il motore diventa molto caldo.”
L’identificatore viene normalizzato:
X Y Z → XYZ.
L’exact lookup individua:
X-Y-Z.
Il manuale potrebbe contenere:
“X-Y-Z – Intervento della protezione termica causato dal superamento della temperatura massima ammessa del motore.”
A questo punto:
- l’exact match ha identificato il codice corretto
- la full-text può valorizzare X-Y-Z, motore, temperatura
- la dense search può riconoscere la relazione semantica fra “diventa molto caldo” e “superamento della temperatura massima ammessa”.
È un esempio molto chiaro di come identità, lessico e significato siano tre problemi differenti.
Prima identificare, poi restringere il retrieval
Quando l’exact matching riesce a identificare l’entità, il risultato può essere utilizzato anche per rendere più precisa la ricerca successiva.
La pipeline può essere:
domanda
↓
riconoscimento del possibile codice
↓
normalizzazione
↓
exact lookup
↓
identificazione del prodotto, errore o modello
↓
restrizione del corpus o filtraggio tramite metadata
↓
dense + full-text retrieval
↓
eventuale rank fusion e reranking
↓
risposta.
Questo approccio è generalmente più robusto di una ricerca semantica indiscriminata sull’intero corpus.
Se so già che la domanda riguarda AB-123, non ho motivo di chiedere al motore vettoriale di scegliere fra migliaia di altri prodotti semanticamente simili.
Posso utilizzare AB-123 come anchor del retrieval e concentrare la ricerca sul contenuto pertinente.
Ricerca vettoriale sparsa: che cosa aggiunge
Accanto alla dense vector search esiste anche la sparse vector search.
In una rappresentazione densa, l’informazione semantica viene distribuita su un numero elevato di dimensioni numeriche e non direttamente interpretabili.
In una rappresentazione sparsa, invece, soltanto una parte delle dimensioni assume valori significativi e queste possono essere maggiormente legate a token o concetti linguistici.
I moderni learned sparse retriever non si limitano necessariamente alla corrispondenza letterale.
Possono attribuire peso anche a termini semanticamente associati alla query.
Per esempio, a partire da:
“surriscaldamento motore”
un modello sparse potrebbe attribuire rilevanza anche a concetti collegati come:
temperatura, termico, overheating, protezione.
In questo senso la sparse retrieval occupa una posizione interessante fra ricerca lessicale e ricerca semantica.
Può conservare una forte sensibilità terminologica introducendo contemporaneamente una forma di espansione semantica.
Sparse search e full-text non producono necessariamente gli stessi risultati
Supponiamo che la query sia:
“errore surriscaldamento motore”
e il manuale dica:
“intervento della protezione termica per superamento della temperatura ammessa”.
Una full-text search tradizionale potrebbe trovare poche corrispondenze letterali.
La sparse search può invece riconoscere associazioni apprese fra:
surriscaldamento
e:
termico, temperatura, protezione.
La dense search può andare ancora oltre e riconoscere la similarità del significato complessivo delle due espressioni.
Possiamo quindi sintetizzare, con una semplificazione utile:
full-text
“Sono presenti questi termini?”
sparse retrieval
“Sono presenti questi termini o termini/concetti fortemente associati?”
dense retrieval
“Il contenuto esprime sostanzialmente lo stesso significato?”
Sparse retrieval è sempre necessario?
No. Ed è un punto importante dal punto di vista architetturale.
Se un sistema dispone già di:
- exact matching normalizzato per codici e identificatori
- full-text retrieval per precisione lessicale
- dense semantic retrieval per similarità di significato
gran parte dello spazio funzionale è già coperto.
Aggiungere anche sparse retrieval può certamente migliorare alcuni casi, soprattutto query brevi, acronimi, gergo tecnico o terminologia molto specialistica.
Ma introduce anche:
- un ulteriore indice
- una nuova graduatoria
- maggiore complessità nella rank fusion
- ulteriori parametri da calibrare
- nuovi costi di evaluation e manutenzione.
La scelta dovrebbe quindi essere basata sui risultati.
Per un corpus di cataloghi e manuali tecnici è ragionevole partire da:
exact match + full-text + dense semantic retrieval
e introdurre sparse retrieval soltanto se benchmark sulle query reali dimostrano che apporta un miglioramento significativo.
La ricerca sparse non sostituisce la normalizzazione dei codici
È importante soprattutto evitare un equivoco.
La sparse retrieval non dovrebbe essere utilizzata come soluzione principale per stabilire che:
AB 123
e:
AB-123
rappresentano lo stesso prodotto.
Un learned sparse model potrebbe riuscire a recuperarli correttamente, ma il risultato dipenderebbe dal modello e dalla tokenizzazione.
Se l’equivalenza delle due grafie è nota a priori, è molto più sicuro normalizzarle deterministicamente.
In altre parole:
non conviene affidare a una probabilità ciò che può essere stabilito con una regola.
La stessa considerazione vale per dense search e full-text.
La semantic search può recuperare il codice corretto.
La lexical search può trovare le sue componenti.
Ma quando l’identità è determinabile attraverso normalizzazione ed exact match, quella è la strada più affidabile.
Una possibile architettura per cataloghi e manuali tecnici
Per un chatbot che dialoga con cataloghi prodotto e manualistica tecnica, la pipeline può quindi essere organizzata in questo modo.
1. Query understanding
Il sistema identifica:
- intento
- possibili codici
- valori
- attributi
- sigle
- entità
- eventuali riferimenti conversazionali.
2. Normalizzazione
I possibili identificatori vengono convertiti nella forma canonica.
3. Exact matching
Una fonte strutturata, per esempio basato sul DB SQL dell’ERP aziendale, verifica se l’identificatore corrisponde a un prodotto, ricambio, modello, errore o altra entità nota.
4. Restrizione del retrieval
Quando l’entità viene identificata, viene utilizzata per restringere il corpus mediante filtri, metadata o associazioni documentali.
5. Retrieval documentale
Si effettuano:
dense semantic search
full-text / lexical search.
6. Rank fusion
Le due graduatorie possono essere combinate.
7. Reranking
Un eventuale reranker seleziona fra i candidati i passaggi maggiormente pertinenti alla domanda.
8. Evidence assembly
I risultati vengono deduplicati, controllati e organizzati nel contesto destinato all’LLM.
La sparse retrieval può essere aggiunta come ulteriore segnale qualora i test dimostrino che aumenta significativamente la qualità del retrieval.
Cinque meccanismi, cinque domande differenti
Il modo più semplice per distinguere le tecniche è chiedersi quale problema stiano risolvendo.
| Meccanismo | Domanda principale |
| Normalizzazione | “Qual è la forma canonica di questo identificatore?” |
| Exact matching | “È esattamente questa entità?” |
| Full-text / lexical search | “Quali contenuti corrispondono maggiormente a questi termini, valori o sigle?” |
| Sparse vector search | “Quali contenuti corrispondono a questi termini o a concetti terminologicamente associati?” |
| Dense vector search | “Quali contenuti esprimono un significato simile alla domanda?” |
Questa distinzione consente di evitare uno degli errori più frequenti nella progettazione di chatbot tecnici: utilizzare la ricerca semantica come soluzione universale.
In realtà, più l’informazione è strutturabile e deterministica, meno è opportuno affidarne il recupero alla sola similarità.
Un codice va innanzitutto identificato.
Un numero esatto va preservato.
Una sigla va riconosciuta.
Una relazione terminologica può beneficiare del lexical retrieval.
Un’intenzione espressa in linguaggio naturale richiede comprensione semantica.
L’efficacia del chatbot nasce dalla capacità di far cooperare questi meccanismi e di utilizzare ciascuno per il problema che sa risolvere meglio.
Prima di cercare occorre talvolta capire che cosa cercare
Esiste poi una categoria di domande ancora più interessante.
L’utente chiede:
“Avete un prodotto equivalente al modello ABC123 del produttore Y?”
Il nostro catalogo contiene perfettamente descritti tutti i nostri prodotti.
Ma nei sistemi aziendali non esiste alcuna parallelizzazione fra ABC123 e uno dei nostri codici.
Una normale ricerca nel corpus aziendale può fallire.
Non perché il prodotto equivalente non esista, ma perché manca l’informazione necessaria a formulare correttamente la ricerca.
È qui che può entrare in gioco il web grounding.
Il sistema può cercare in fonti pubbliche le caratteristiche tecniche del prodotto ABC123, trasformarle in una descrizione neutra e strutturata e utilizzare successivamente tali caratteristiche per interrogare il corpus interno.
La sequenza diventa quindi: prodotto esterno → acquisizione delle caratteristiche → normalizzazione → ricerca nel catalogo aziendale → confronto fra candidati → risposta.
Il web, in questo caso, non sostituisce la conoscenza aziendale, la completa.
Fornisce il ponte necessario per tradurre un riferimento esterno in una rappresentazione che il sistema interno possa utilizzare.
Il grounding esterno deve essere subordinato alle fonti aziendali
Questa capacità richiede però una governance molto chiara.
Non sarebbe corretto trasformare automaticamente Internet nella fonte principale del chatbot.
Se l’azienda possiede già una relazione ufficialmente validata fra il codice del concorrente e un proprio articolo, utilizzare il web è inutile.
È quindi preferibile che il sistema verifichi innanzitutto se l’informazione necessaria è già disponibile internamente.
Solo quando questa manca può procedere all’arricchimento esterno.
Inoltre, il grounding esterno deve mantenere un ruolo epistemico ben definito.
Può essere molto utile per conoscere le caratteristiche pubbliche di un prodotto esterno.
Non dovrebbe invece prevalere sull’ERP per determinare la nostra disponibilità, sul nostro listino per stabilire il prezzo, su un manuale approvato per definire una procedura di sicurezza o sul nostro product data validato per stabilire le caratteristiche ufficiali di ciò che vendiamo.
Il punto non è semplicemente disporre di molte fonti, è sapere quale fonte è autorevole per quale tipo di affermazione.
Dalla similarità alle relazioni: il ruolo dei Knowledge Graph
La ricerca vettoriale introduce una straordinaria capacità di trovare contenuti semanticamente affini.
Ma esiste una classe di problemi per cui la similarità non è sufficiente.
Consideriamo la domanda:
“Qual è il ricambio del componente X?”
Il sistema potrebbe ricercare nei documenti i contenuti semanticamente più simili a X.
Ma il vero problema non è trovare qualcosa che assomigli a X.
È sapere quale prodotto intrattiene con X la relazione:
HA_RICAMBIO
oppure:
È_RICAMBIO_DI.
È una differenza fondamentale.
Un Knowledge Graph rappresenta esplicitamente entità, proprietà e relazioni.
Potremmo avere:
Prodotto A → HA_RICAMBIO → Prodotto B
Utensile C → ADATTO_PER → Materiale D
Accessorio E → COMPATIBILE_CON → Macchina F
Prodotto G → SOSTITUISCE → Prodotto H
Componente I → APPARTIENE_A → Assieme L
Queste relazioni non vengono inferite soltanto dalla vicinanza fra descrizioni testuali: sono modellate esplicitamente.
Come emerge anche dai lavori dedicati all’engineering dei Knowledge Graph per applicazioni LLM, la modellazione semantica risponde a domande fondamentali: che cosa rappresenta un’entità, quali proprietà la caratterizzano e come essa si relaziona alle altre entità del dominio.
È qui che ontologia e schema design assumono un ruolo centrale.
Similarità implicita e relazione esplicita
La differenza fra Vector RAG e Graph RAG può essere sintetizzata così: la ricerca vettoriale scopre soprattutto vicinanze; il grafo rappresenta relazioni.
Due prodotti possono avere descrizioni quasi identiche senza essere intercambiabili.
Un componente può essere il ricambio ufficiale di un altro pur avendo una descrizione testuale molto diversa.
Due utensili semanticamente simili possono appartenere a gamme differenti e avere incompatibilità tecniche decisive.
In un dominio industriale questo aspetto assume un’importanza particolare.
Il Knowledge Graph permette di rappresentare non soltanto che due entità sono collegate, ma in che modo sono collegate, in quale direzione e, se necessario, sotto quali condizioni.
La relazione diventa quindi conoscenza interrogabile.
Thomas Frisendal, in Graph Data Modeling for NoSQL and SQL: Visualize Structure and Meaning, insiste proprio sulla capacità della modellazione a grafo di rappresentare non soltanto la struttura dei dati, ma anche il loro significato.
Le relazioni, dotate di etichette parlanti e direzione, costituiscono in questo senso un vero livello narrativo del modello: descrivono ciò che accade fra le entità.
Attraversare il grafo significa seguire un percorso logico
Un altro vantaggio del Knowledge Graph emerge quando la risposta richiede più passaggi.
Supponiamo di voler rispondere a una domanda che implica:
individuare un utensile;
determinare il materiale per cui è indicato;
individuare gli accessori compatibili;
verificare quale di questi accessori appartenga a una determinata categoria.
La ricerca vettoriale può trovare singoli contenuti pertinenti.
Il grafo permette invece di attraversare una catena di relazioni, esplorandole e scoprendole.
Michael Trevd, in The Complete Graph RAG Handbook, pone l’accento proprio su questo limite del RAG puramente semantico: quando la risposta richiede di collegare informazioni distribuite fra più entità e seguire un filo logico, la similarità puntuale fra query e documenti può non essere sufficiente.
Nel grafo le unità di conoscenza possono essere rappresentate come affermazioni elementari che collegano un soggetto, una relazione e un oggetto.
Queste unità possono essere attraversate e concatenate.
Il sistema parte dall’entità riconosciuta nella domanda, percorre le relazioni rilevanti e costruisce un sottografo contenente le informazioni necessarie.
In questo modo non recupera soltanto ciò che “somiglia” alla domanda: recupera ciò che è logicamente connesso all’oggetto della domanda ed eventualmente può inferire nuova conoscenza in base a regole logiche.
Vector RAG e Graph RAG non sono concorrenti
Anche in questo caso la soluzione più interessante non consiste nello scegliere una tecnica ed escludere l’altra.
Vector RAG e Graph RAG risolvono problemi differenti.
Il primo eccelle nel riconoscimento della pertinenza semantica.
Il secondo nella navigazione di entità e relazioni esplicite.
È quindi possibile usare la ricerca semantica per individuare l’entità o il tema da cui partire e il grafo per esplorarne le relazioni.
Oppure fare il contrario: utilizzare il grafo per restringere il dominio dei candidati e successivamente recuperare dal corpus i passaggi testuali che documentano o spiegano quelle relazioni.
Il risultato può essere un contesto composto contemporaneamente da: evidenze semanticamente rilevanti e evidenze logicamente collegate.
È questo uno dei significati più interessanti della combinazione fra Vector RAG e Graph RAG.
Ma non tutto ciò che arriva dal grafo deve essere sottoposto a reranking
Qui serve nuovamente una distinzione.
Se nel Knowledge Graph esiste una relazione validata:
Prodotto A → HA_RICAMBIO → Prodotto B
e la domanda è:
“Qual è il ricambio del prodotto A?”
non è utile sottoporre il prodotto B a un modello semantico affinché stabilisca quanto sia “pertinente”. La relazione è già un fatto esplicito.
Diverso è il caso in cui il grafo restituisca decine di entità collegate e debba essere determinato quali siano maggiormente rilevanti rispetto a una domanda complessa.
Il retrieval da Knowledge Graph può quindi svolgere ruoli differenti: fornire direttamente dati di fatto relazionali, filtrare i candidati, ampliare una ricerca oppure produrre contenuti che verranno successivamente confrontati con quelli provenienti dal retrieval vettoriale.
L’architettura non dovrebbe applicare indiscriminatamente la stessa pipeline a qualunque tipo di evidenza.
Ontologia: la qualità del grafo nasce prima del database
Un Knowledge Graph non è utile semplicemente perché i dati vengono inseriti in un database a grafo. La qualità deriva in larga parte dal lavoro di modellazione del dominio.
Occorre definire che cosa debba diventare un’entità, che cosa debba rimanere una proprietà e quali relazioni abbiano effettivo valore informativo.
In un catalogo di utensileria, per esempio, potrebbe essere sensato rappresentare come entità prodotti, categorie, materiali, macchine, lavorazioni e componenti.
Diametro, lunghezza e codice potrebbero invece essere proprietà del prodotto.
Non esiste però una soluzione universalmente corretta.
Lo schema deve essere progettato partendo anche dalle domande che il sistema sa saper risolvere. Questo principio è particolarmente importante: il Knowledge Graph va progettato anche a partire dai query pattern.
Se desidero che il chatbot sappia rispondere a domande sui ricambi, devo rappresentare la relazione di ricambio.
Se desidero supportare la compatibilità, devo modellare la compatibilità.
Se desidero ragionare su sostituzioni, precedenze, appartenenze, lavorazioni o vincoli, queste dimensioni devono trovare una rappresentazione coerente nell’ontologia.
Graph RAG non significa semplicemente “aggiungere un grafo alla RAG”: significa modellare esplicitamente una parte della conoscenza aziendale che prima era dispersa o implicita nei documenti.
Entity linking: prodotti, sinonimi e linguaggio reale degli utenti
La modellazione a entità introduce un ulteriore vantaggio.
Nel linguaggio reale, lo stesso oggetto viene spesso denominato in modi differenti.
Una tassonomia può stabilire che “giravite” e “cacciavite” fanno riferimento allo stesso concetto.
A quel concetto possono poi essere associati prodotti specifici.
Il vantaggio consiste nel separare la cosa dai termini utilizzati per nominarla.
Il sistema può quindi riconoscere varianti linguistiche, denominazioni alternative e gergo tecnico e ricondurli a un’identità canonica.
Questo processo di entity linking è essenziale per un chatbot tecnico.
Lo stesso vale per le conversazioni multi-turno.
Se l’utente prima parla di un utensile e nel messaggio successivo chiede:
“Esiste anche nella versione isolata?”
il sistema deve risolvere il riferimento implicito di “nella versione isolata” all’entità discussa nel turno precedente.
Query understanding, entity resolution e gestione della coreference diventano quindi parte integrante dell’accesso alla conoscenza.
Consigli ed esempi per progettare Knowledge Graph utili alla Graph RAG in cataloghi e manuali tecnici
La ricerca vettoriale è particolarmente efficace quando il problema consiste nel trovare contenuti semanticamente pertinenti alla domanda dell’utente. Esistono però richieste per le quali la similarità semantica non è sufficiente.
Consideriamo alcune domande tipiche:
“Qual è il ricambio del prodotto AB-123?”
“Quali accessori sono compatibili con questa macchina?”
“Questo prodotto sostituisce il modello precedente?”
“Qual è il manuale corretto per questa versione della macchina?”
“In quale revisione del manuale è documentato l’errore E104?”
“Quale prodotto appartiene a questa famiglia ed è adatto alla lavorazione dell’acciaio inossidabile?”
In questi casi non bisogna semplicemente trovare un testo che “parla di qualcosa di simile”. Bisogna identificare entità e percorrere relazioni precise fra di esse.
È qui che un Knowledge Graph può aggiungere alla pipeline RAG una capacità differente: accanto alla rilevanza semantica dei contenuti introduce conoscenza strutturata sulle cose che compongono il dominio e sulle relazioni che intercorrono fra loro.
Il Knowledge Graph non è soltanto uno schema del catalogo
Una prima distinzione è fondamentale.
Potremmo descrivere astrattamente il nostro dominio dicendo che:
una categoria contiene sottocategorie;
una sottocategoria contiene prodotti;
un prodotto può avere ricambi;
un prodotto può avere accessori;
un manuale documenta uno o più prodotti.
Questa rappresentazione descrive lo schema, o ontologia, del dominio.
Definisce cioè quali tipi di entità esistono e quali tipi di relazione possono collegarle.
Per esempio:
Categoria
↓ CONTIENE
Sottocategoria
↓ CONTIENE
Prodotto
↓ HA_RICAMBIO
Prodotto
Ma per essere realmente utile alla Graph RAG il grafo deve contenere anche le istanze effettive.
Per esempio:
Punte per metallo
↓ CONTIENE
Punte HSS-Co
↓ CONTIENE
Serie Alpha
↓ HA_VARIANTE
AB-123
e:
AB-123
── HA_RICAMBIO ──> RC-456
AB-123
── HA_ACCESSORIO ──> AC-178
Se il chatbot deve rispondere:
“Qual è il ricambio di AB-123?”
non basta che il grafo sappia genericamente che “un prodotto può avere un ricambio”.
Deve conoscere il fatto concreto:
AB-123 HA_RICAMBIO RC-456.
Lo schema definisce quindi quali relazioni sono possibili.
Il Knowledge Graph contiene quali relazioni esistono realmente.
Il grafo va progettato a partire dalle domande
Un errore frequente consiste nel partire dai dati disponibili e cercare di trasformarli tutti in un grafo.
Per Graph RAG è spesso più efficace procedere nella direzione opposta.
Occorre innanzitutto chiedersi:
Quali domande vogliamo che il chatbot sappia risolvere attraversando relazioni?
Per un catalogo tecnico i query pattern potrebbero essere:
- qual è il ricambio di questo prodotto?
- quali accessori sono compatibili?
- quale prodotto sostituisce questo modello?
- quali prodotti appartengono alla stessa famiglia?
- quali varianti esistono?
- quale prodotto è equivalente a questo?
- quali prodotti sono adatti a questo materiale?
- quale componente appartiene a questo assieme?
Per la manualistica:
- quale manuale documenta questo prodotto?
- quale revisione è applicabile?
- in quale documento è descritto questo errore?
- quale procedura riguarda questo componente?
- quale scheda tecnica appartiene a questa famiglia?
- quale documento sostituisce quello precedente?
- quale manuale è valido per una determinata versione, matricola o configurazione?
Sono questi query pattern a suggerire quali entità e relazioni devono esistere nel grafo.
Michael Trevd, in The Complete Graph RAG Handbook, sottolinea proprio l’importanza di progettare lo schema tenendo presenti i percorsi di query e le operazioni di attraversamento che il sistema dovrà supportare.
Schema.org può essere un punto di partenza, non necessariamente il punto di arrivo
Per modellare il catalogo può essere utile partire da vocabolari già esistenti, per esempio dai concetti generali associati a Product, ProductModel e ProductGroup.
Questo permette di non reinventare completamente la semantica di concetti comuni come prodotto, modello, variante, accessorio o prodotto correlato.
Ma un Knowledge Graph destinato alla Graph RAG aziendale deve soprattutto rappresentare la semantica specifica del dominio tecnico.
Potrebbe quindi essere necessario distinguere relazioni quali:
HA_RICAMBIO
HA_ACCESSORIO
È_COMPATIBILE_CON
È_VARIANTE_DI
SOSTITUISCE
È_EQUIVALENTE_A
È_ADATTO_PER
APPARTIENE_A
È_COMPONENTE_DI
Queste relazioni non sono intercambiabili.
Dire che due prodotti sono “correlati” è molto meno informativo che sapere che:
A ── HA_RICAMBIO ──> B
oppure:
A ── È_COMPATIBILE_CON ──> C
L’etichetta della relazione costituisce essa stessa conoscenza.
Come osserva Thomas Frisendal in Graph Data Modeling for NoSQL and SQL, entità e relazioni permettono di rappresentare contemporaneamente struttura e significato; inoltre la direzione della relazione contribuisce a esprimere la semantica del dominio.
Prodotti, codici e varianti: quanto deve essere granulare il grafo?
Per un catalogo tecnico, se il chatbot deve poter ragionare su prodotti reali, è normalmente opportuno che nel grafo esistano anche i prodotti identificati dai rispettivi codici.
Questo non significa duplicare nel Knowledge Graph l’intero PIM.
Un nodo prodotto può essere relativamente leggero:
Product
entity_id = PRODUCT_84567
sku = AB-123
normalized_sku = AB123
name = Punta elicoidale…
Le informazioni commerciali che cambiano frequentemente – per esempio prezzo, disponibilità, sconto, stock – possono continuare a essere recuperate dal database gestionale.
Analogamente, le lunghe descrizioni discorsive possono rimanere nel corpus utilizzato dalla ricerca vettoriale.
Il Knowledge Graph contiene soprattutto identità, proprietà necessarie al traversal e relazioni.
Una possibile distribuzione è quindi:
Knowledge Graph → scheletro relazionale
Vector DB → contenuto discorsivo
PIM/ERP/SQL → dati strutturati e dati vivi
È una separazione molto importante perché evita di utilizzare il grafo come copia di sistemi che già svolgono meglio altre funzioni.
Famiglia, modello e singolo codice possono essere livelli diversi
Nei cataloghi industriali è frequente avere una famiglia di prodotto con numerose varianti.
Per esempio:
Serie Alpha
── HA_VARIANTE ──> AB-108 [Ø 8 mm]
── HA_VARIANTE ──> AB-110 [Ø 10 mm]
── HA_VARIANTE ──> AB-112 [Ø 12 mm]
Una relazione comune può essere posta al livello della famiglia:
Serie Alpha
── ADATTA_PER ──>
Acciaio inossidabile
mentre gli attributi specifici rimangono sulle singole varianti:
AB-110
diametro = 10 mm
e una relazione che vale soltanto per un particolare codice può essere:
AB-110
── HA_RICAMBIO ──>
RC-110
Questo evita di replicare inutilmente la stessa conoscenza su centinaia di SKU e consente al grafo di rappresentare correttamente i diversi livelli della struttura merceologica.
Non ogni attributo deve diventare un nodo
La progettazione del grafo richiede una scelta importante: questa informazione deve essere una proprietà oppure un’entità?
Per esempio:
diametro = 10 mm
lunghezza = 120 mm
peso = 350 g
possono normalmente essere proprietà del nodo prodotto.
Non è necessario trasformare 10 mm in un nodo e creare:
AB-110 ── HA_DIAMETRO ──> 10 mm
Diverso è il caso di:
AB-110
── ADATTO_PER ──>
Acciaio inossidabile
Acciaio inossidabile può essere un’entità perché:
- molti prodotti possono essere collegati allo stesso materiale
- il materiale può appartenere a una tassonomia
- può possedere sinonimi
- può intrattenere altre relazioni
- può essere utilizzato come punto di partenza per ulteriori attraversamenti.
Una buona regola pratica è: se un elemento deve essere condiviso, attraversato, collegato ad altre entità o interrogato autonomamente, è un buon candidato per diventare un nodo; se serve principalmente a descrivere un’entità, è spesso più opportuno rappresentarlo come proprietà.
Categorie e sottocategorie possono diventare una vera tassonomia
Anche la classificazione merceologica può entrare nel Knowledge Graph.
Per esempio:
Utensili da taglio
↓
Punte
↓
Punte per metallo
↓
Punte HSS-Co
e:
AB-123
── APPARTIENE_A ──>
Punte HSS-Co
Il vantaggio non consiste soltanto nel poter navigare la gerarchia.
È possibile associare ai concetti una terminologia controllata.
Per esempio:
Concetto: Giravite
termine preferito:
giravite
sinonimi:
cacciavite
cacciaviti
giraviti
Il prodotto reale viene poi collegato al concetto:
AB-456
── APPARTIENE_A ──>
Giravite
In questo modo il Knowledge Graph può contribuire anche all’entity linking e alla gestione della terminologia.
L’utente può parlare di “cacciavite”, mentre il catalogo utilizza “giravite”: entrambi vengono ricondotti allo stesso concetto.
Questo aspetto è particolarmente utile in cataloghi tecnici, dove linguaggio commerciale, terminologia normativa e gergo degli utilizzatori possono differire sensibilmente.
Le relazioni tecniche possono avere condizioni
Non tutte le relazioni sono assolute.
Consideriamo:
Prodotto A
── È_EQUIVALENTE_A ──>
Prodotto B
Che cosa significa esattamente “equivalente”?
Potrebbe significare:
- equivalente in una determinata applicazione
- equivalente soltanto per alcune misure
- equivalente secondo una parallelizzazione commerciale
- equivalente validato tecnicamente
- possibile alternativa, ma non sostituzione certificata.
La relazione può quindi avere proprie proprietà:
scope = “applicazione X”
validated = true
source = “ufficio tecnico”
validFrom = …
confidence = …
Lo stesso può valere per:
COMPATIBILE_CON
ADATTO_PER
SOSTITUISCE
Questo è particolarmente importante perché un Knowledge Graph non deve soltanto collegare entità: deve rappresentare il significato e, quando necessario, le condizioni della relazione.
Andrew Bar, in Engineering Knowledge Graphs for LLM Applications, evidenzia proprio l’importanza di associare alla modellazione semantica informazioni come provenienza, tempo, condizioni e livello di affidabilità.
Integrare cataloghi e documentazione tecnica nello stesso Knowledge Graph
Per la manualistica tecnica non è opportuno progettare un Knowledge Graph completamente separato da quello dei prodotti.
Il valore maggiore emerge quando prodotti e documenti appartengono allo stesso grafo del dominio.
Possiamo avere entità come:
Product
ProductFamily
Component
Manual
DataSheet
SafetyDataSheet
ErrorCode
Procedure
e relazioni quali:
Manuale M-100
── DOCUMENTA ──>
Macchina K
Scheda tecnica ST-100
── DESCRIVE ──>
Prodotto AB-123
Manuale M-100
── CONTIENE_ERRORE ──>
E104
Questo consente di attraversare il confine fra ciò che esiste nel catalogo e la documentazione che ne descrive funzionamento, utilizzo e manutenzione.
Non serve trasformare ogni frase del manuale in triple
Anche in questo caso è utile mantenere una divisione dei compiti.
Il Knowledge Graph potrebbe sapere:
E104
── È_ERRORE_DI ──>
Macchina K
E104
── DOCUMENTATO_IN ──>
Manuale M-100 Rev.3
Il corpus vettoriale contiene invece il testo:
“L’errore E104 viene generato quando la temperatura del motore supera…”
Non occorre convertire ogni frase del manuale in decine di triple.
Il grafo permette di determinare:
quale entità, quale documento e quale percorso sono rilevanti.
La ricerca vettoriale recupera successivamente:
quale passaggio del documento contiene la spiegazione necessaria.
Questa complementarità evita sia un vector store privo di struttura sia un Knowledge Graph eccessivamente dettagliato e difficile da mantenere.
Versioni e revisioni dei manuali devono essere parte della conoscenza
La gestione delle revisioni è un ottimo esempio di informazione che un grafo può rappresentare meglio di una semplice raccolta di PDF.
È opportuno distinguere:
identità logica del documento
da:
specifica revisione del documento.
Per esempio:
Manuale M-100
── HA_REVISIONE ──> M-100 Rev.1
── HA_REVISIONE ──> M-100 Rev.2
── HA_REVISIONE ──> M-100 Rev.3
Le revisioni possono essere collegate temporalmente:
Rev.3
── SOSTITUISCE ──>
Rev.2
Rev.2
── SOSTITUISCE ──>
Rev.1
e possedere proprietà quali:
revision = 3
publicationDate = …
validFrom = …
validTo = …
status = current
Questo permette al chatbot di non limitarsi a trovare “un manuale che parla del prodotto”, ma di individuare la revisione applicabile.
Anche lingua e formato possono essere livelli distinti
Se la stessa revisione è disponibile in più lingue, si può distinguere la revisione logica dalle sue rappresentazioni:
Manuale M-100
↓
Revisione 3
── HA_RAPPRESENTAZIONE ──> PDF IT
── HA_RAPPRESENTAZIONE ──> PDF EN
── HA_RAPPRESENTAZIONE ──> PDF DE
Questo evita di confondere il concetto di revisione del contenuto con quello di traduzione o formato del file.
L’applicabilità di una revisione può diventare una relazione interrogabile
In molti settori tecnici il problema non consiste soltanto nel sapere quale sia il manuale più recente.
Occorre sapere quale manuale sia applicabile a quella specifica macchina.
Per esempio:
Manuale M-100 Rev.2
── SI_APPLICA_A ──>
Macchina K
con proprietà della relazione:
serialFrom = 200001
serialTo = 249999
mentre:
Manuale M-100 Rev.3
── SI_APPLICA_A ──>
Macchina K
potrebbe avere:
serialFrom = 250000
A questo punto la domanda:
“Ho una macchina K matricola 280431: quale manuale devo consultare?”
non è più un semplice problema di semantic search.
È un problema relazionale:
modello K + matricola 280431 → revisione applicabile → manuale corretto.
Il grafo rende questo percorso esplicito.
Provenance: una relazione deve poter essere verificata
Quando il Knowledge Graph viene alimentato automaticamente da cataloghi e manuali, è importante poter rispondere a una domanda:
Da dove deriva questa relazione?
Se dal catalogo viene estratto:
AB-123
── HA_RICAMBIO ──>
RC-456
potrebbero essere memorizzate anche informazioni quali:
source_document = Catalogo_2026.pdf
source_page = 418
revision = 2026.1
extraction_method = automated
validation_status = approved
Lo stesso vale per:
E104
── HA_CAUSA ──>
Sovratemperatura
Questo provenance tracking permette di verificare le estrazioni, risolvere conflitti e supportare la spiegabilità della risposta.
Nei tuoi appunti emerge proprio l’importanza di poter ricostruire da quale pagina e da quale documento sia stata estratta una determinata informazione.
Come il grafo entra nella pipeline RAG
Il Knowledge Graph non deve necessariamente essere interrogato per ogni domanda.
Serve un query router in grado di decidere quando il problema richieda:
- soltanto Vector RAG
- soltanto una query sul grafo
- oppure una combinazione di Graph RAG e Vector RAG.
Una domanda come:
“Come si effettua il reset dopo l’errore E104?”
può essere prevalentemente documentale.
Una domanda come:
“Qual è il ricambio di AB-123?”
è principalmente relazionale.
Una domanda come:
“Qual è il ricambio di AB-123 e quali sono le istruzioni per sostituirlo?”
richiede entrambi.
È quindi utile distinguere tre scenari.
Solo Vector RAG
Domanda:
“Come si calibra il sensore?”
La risposta può essere recuperata direttamente dai contenuti del manuale.
Pipeline:
query
↓
dense + lexical retrieval
↓
reranking
↓
context window
↓
LLM
Solo Graph RAG o query deterministica sul grafo
Domanda:
“Qual è il ricambio ufficiale di AB-123?”
Se il Knowledge Graph contiene la relazione validata:
AB-123 ── HA_RICAMBIO ──> RC-456
può non essere necessario cercare semanticamente una risposta.
Il grafo contiene già il fatto.
Graph RAG + Vector RAG
Domanda:
“Qual è il ricambio di AB-123 e come va installato?”
Il primo problema è relazionale:
AB-123
↓ HA_RICAMBIO
RC-456
Il secondo è documentale.
Il risultato del grafo può quindi diventare l’anchor della ricerca vettoriale:
RC-456
↓
manuali/documenti associati
↓
Vector RAG
↓
passaggi relativi all’installazione
In questo modo il grafo restringe e orienta il retrieval.
Come avviene l’attraversamento del grafo
Una pipeline Graph RAG può seguire una sequenza di questo tipo.
1. Query understanding
L’LLM individua nella domanda:
- entità
- possibili codici
- relazione richiesta
- eventuali vincoli
- obiettivo della ricerca.
Domanda:
“Qual è il ricambio della punta AB 123?”
può diventare:
entity = AB123
relation = HA_RICAMBIO
2. Entity resolution
La normalizzazione e l’exact lookup di cui abbiamo parlato precedentemente possono identificare:
AB123
→
entity_id = PRODUCT_84567
3. Individuazione dell’entità di partenza
Il nodo:
PRODUCT_84567
diventa il punto di ingresso nel grafo.
4. Traversal
Il sistema segue la relazione pertinente:
PRODUCT_84567
── HA_RICAMBIO ──>
PRODUCT_93215
Nelle domande più complesse il traversal può richiedere più passaggi.
Per esempio:
Prodotto
↓ APPARTIENE_A
Famiglia
↓ ADATTA_PER
Materiale
oppure:
Macchina
↓ DOCUMENTATA_DA
Manuale
↓ HA_REVISIONE
Revisione
↓ CONTIENE_ERRORE
E104
Le triple possono quindi essere concatenate per costruire percorsi logici. Questo carattere di attraversabilità e componibilità è uno dei punti centrali della Graph RAG.
La profondità del traversal deve dipendere dalla domanda
Non è necessario attraversare indiscriminatamente l’intero grafo.
La query deve contribuire a stabilire:
- l’entità iniziale
- il tipo di relazione
- la direzione
- i vincoli
- il numero massimo di salti.
Se la domanda è:
“Qual è il ricambio di X?”
può bastare un solo hop:
X → HA_RICAMBIO → Y
Se invece chiede:
“Quali accessori sono compatibili con i ricambi della famiglia X?”
potrebbero essere necessari più passaggi:
Famiglia X
↓ HA_PRODOTTO
Prodotto
↓ HA_RICAMBIO
Ricambio
↓ HA_ACCESSORIO_COMPATIBILE
Accessorio
Questo evita di recuperare un sottografo enorme e poco pertinente.
Il sottografo recuperato deve essere trasformato in contesto utilizzabile
Un LLM non deve necessariamente ricevere direttamente la struttura interna del database a grafo.
Dopo il traversal si estrae il sottografo rilevante e lo si trasforma in una rappresentazione compatta e comprensibile.
Per esempio:
AB-123
HA_RICAMBIO
RC-456
RC-456
DOCUMENTATO_IN
Manuale M-200 Rev.4
può essere trasformato in:
“Il ricambio associato al prodotto AB-123 è RC-456. Il ricambio RC-456 è documentato nel Manuale M-200, revisione 4.”
Questo processo di subgraph extraction e linearizzazione permette di inserire le relazioni recuperate nel context window insieme ai passaggi provenienti dalla ricerca vettoriale.
Graph RAG e Vector RAG producono evidenze differenti
Questo è il punto centrale della loro integrazione.
Il Vector RAG può recuperare:
“Per sostituire il componente RC-456, scollegare…”
Il Graph RAG può fornire:
AB-123 → HA_RICAMBIO → RC-456
SQL può aggiungere:
RC-456
stock = 12
Sono tre evidenze differenti:
Graph RAG
relazione.
Vector RAG
spiegazione documentale.
SQL
dato strutturato aggiornato.
Non è necessario costringerle tutte a passare attraverso lo stesso meccanismo di ranking.
Una relazione deterministica e validata dal Knowledge Graph o un valore recuperato esattamente da SQL possono essere inseriti nel contesto come fatti.
I contenuti documentali recuperati semanticamente possono invece essere sottoposti a ranking e reranking.
Quando ha senso fondere i risultati
Se Graph RAG e Vector RAG producono numerosi candidati o quando occorre integrare evidenze relazionali e documentali nella risposta a una domanda complessa, può essere utile applicare un processo di context fusion.
Per esempio:
Vector retrieval
→ 20 candidati
Graph retrieval
→ 20 candidati / relazioni
Una fase successiva può:
- filtrare
- deduplicare
- privilegiare le evidenze maggiormente pertinenti
- risolvere eventuali contraddizioni, per esempio in base alla gerarchia di autorevolezza delle fonti
- preservare la provenance
- selezionare le informazioni da inserire nel context window.
Un esempio completo: ricambio e istruzioni di sostituzione
Domanda:
“Qual è il ricambio della punta AB 123 e come si sostituisce?”
Query understanding
codice = AB 123
intento 1 = trovare ricambio
intento 2 = procedura di sostituzione
Normalizzazione ed exact matching
AB 123
→ AB123
→ PRODUCT_84567
Graph traversal
PRODUCT_84567
↓ HA_RICAMBIO
PRODUCT_93215 / RC-456
Nuovo traversal documentale
RC-456
↓ DOCUMENTATO_IN
Manuale M-200 Rev.4
Vector retrieval
Il sistema limita la ricerca al manuale pertinente e cerca semanticamente:
“procedura sostituzione RC-456”
Context assembly
Il context window riceve:
Fatto relazionale:
AB-123 ha come ricambio RC-456.
Fonte documentale:
passaggio del Manuale M-200 Rev.4 che descrive la sostituzione.
Generazione
L’LLM può finalmente costruire una risposta che combina:
identificazione certa del ricambio
istruzioni documentate per la sostituzione.
La ricerca vettoriale da sola avrebbe potuto forse ricostruire entrambe le informazioni, ma il grafo rende esplicito e governabile il passaggio logico fra prodotto, ricambio e documento.
Un secondo esempio: individuare il manuale corretto per una macchina
Domanda:
“Ho una macchina K matricola 280431 e compare l’errore E104. Cosa devo fare?”
Query understanding
model = K
serial = 280431
error = E104
Entity resolution
K → MODEL_K
E104 → ERROR_E104
Graph traversal
Il grafo può stabilire:
MODEL_K
↓ HA_MANUALE
M-100
M-100
↓ HA_REVISIONE
Rev.2
Rev.3
Le relazioni di applicabilità indicano:
Rev.2
serialTo = 249999
Rev.3
serialFrom = 250000
Il sistema determina quindi:
280431
→
Rev.3
e verifica:
Rev.3
↓ DOCUMENTA
E104
Vector retrieval
La ricerca viene limitata a:
Manuale M-100
Revisione 3
e recupera il testo che descrive:
- significato dell’errore
- cause
- eventuale procedura prevista.
In questo caso il Knowledge Graph non formula la risposta tecnica.
Svolge una funzione altrettanto importante:
determina quale sia la fonte corretta sulla quale fondare la risposta.
Il valore fondamentale della Graph RAG
La ricerca vettoriale risponde molto bene a:
“Quale testo è semanticamente pertinente?”
Il Knowledge Graph aggiunge domande differenti:
“Quale entità è collegata a questa?”
“Attraverso quale relazione?”
“In quale direzione?”
“Con quali condizioni?”
“Quale percorso collega queste informazioni?”
“Quale fonte documenta questa relazione?”
“Quale revisione è applicabile?”
Questa è la ragione principale per cui Graph RAG e Vector RAG possono essere complementari.
La prima introduce struttura e percorsi logici.
La seconda recupera contenuti discorsivi semanticamente pertinenti.
Il grafo non deve diventare una copia dell’intero patrimonio informativo
La progettazione deve però rimanere selettiva.
Un Knowledge Graph utile alla Graph RAG non deve necessariamente contenere:
- ogni frase;
- ogni valore;
- ogni attributo;
- ogni riga del catalogo;
- ogni dettaglio già presente nel PIM;
- ogni informazione transazionale.
Dovrebbe contenere soprattutto ciò che acquista valore quando viene rappresentato come:
entità
relazione
proprietà necessarie a descrivere entità e relazioni
provenance.
Una possibile distribuzione delle responsabilità è:
| Fonte | Funzione prevalente |
| Knowledge Graph | entità, tassonomie, relazioni, applicabilità, versioni, dipendenze |
| Vector DB | descrizioni, spiegazioni, istruzioni, procedure, contenuti discorsivi |
| SQL/PIM/ERP | identificatori, attributi strutturati, prezzo, stock, dati transazionali |
| Metadata | collegamento fra documenti, chunk, prodotti, revisioni ed entità |
Il valore nasce dall’integrazione, non dalla duplicazione.
Un identificatore comune collega l’intera architettura
Perché tutto questo funzioni, è particolarmente utile disporre di un’identità canonica condivisa.
Per esempio:
entity_id = PRODUCT_84567
può essere utilizzato: nel database SQL; nel Knowledge Graph; nei metadata dei documenti; nei chunk del vector store.
La pipeline può quindi passare senza ambiguità da un sistema all’altro:
query utente
↓
exact lookup
↓
entity_id
↓
Knowledge Graph
↓
entità correlate
↓
document_id / revision_id
↓
Vector RAG
L’identity layer diventa così la vera infrastruttura che collega ricerca strutturata, Graph RAG e ricerca semantica.
In sintesi: progettare il grafo per farlo attraversare
Per essere utile alla Graph RAG, un Knowledge Graph per cataloghi e manuali tecnici dovrebbe quindi essere progettato seguendo alcuni principi:
- partire dalle domande che richiedono relazioni, non semplicemente dai dati disponibili
- definire un’ontologia compatta ma semanticamente precisa, eventualmente partendo da vocabolari esistenti e specializzandoli per il dominio
- inserire nel grafo le istanze reali necessarie al traversal, non soltanto categorie astratte
- distinguere proprietà da entità, evitando di trasformare ogni attributo in un nodo
- rappresentare esplicitamente ricambi, accessori, compatibilità, equivalenze, sostituzioni e appartenenze
- collegare prodotti e documentazione nello stesso dominio di conoscenza
- modellare revisioni, applicabilità e successione dei documenti
- associare provenance e stato di validazione alle relazioni importanti
- condividere identificatori canonici fra SQL, Knowledge Graph e vector store
- utilizzare il query router per stabilire quando attraversare il grafo e quando utilizzare soltanto Vector RAG.
L’obiettivo non è costruire il Knowledge Graph più grande possibile.
È costruire il grafo minimo sufficientemente ricco da rendere espliciti e attraversabili i percorsi logici che le domande degli utenti richiedono.
È proprio questo che il grafo aggiunge alla pipeline RAG: non soltanto nuovi contenuti da recuperare, ma una struttura che dice quali cose sono collegate, in che modo sono collegate e quale percorso seguire per arrivare alle evidenze corrette.
Provenienza: sapere non soltanto che cosa è vero, ma da dove deriva
Un altro requisito fondamentale per applicazioni tecniche è la provenienza (provenance).
Quando una relazione del Knowledge Graph viene estratta da un manuale, quando un attributo proviene da un catalogo oppure quando un’informazione è stata ricavata da una fonte esterna, il sistema dovrebbe essere in grado di ricostruirne l’origine.
La domanda fondamentale diventa:
“Da quale fonte deriva questa affermazione?”
Per una relazione estratta automaticamente da un documento potremmo voler sapere documento, versione, pagina, data di estrazione, livello di confidenza e stato di validazione.
La provenienza migliora contemporaneamente affidabilità, trasparenza, verificabilità, manutenzione e spiegabilità.
Diventa inoltre indispensabile quando fonti diverse entrano in conflitto.
Se una vecchia brochure e una scheda prodotto aggiornata riportano valori differenti, l’applicazione deve possedere criteri per stabilire quale informazione debba prevalere.
Una gerarchia delle fonti è necessaria
In un chatbot evoluto il context window può ricevere contemporaneamente evidenze provenienti da documenti, database relazionali, Knowledge Graph e web.
Queste fonti non devono avere necessariamente la stessa autorità.
Un possibile principio generale è semplice: ogni fonte deve essere autorevole nel proprio dominio.
L’ERP può essere la fonte autorevole per stock e prezzi.
Il manuale approvato per istruzioni di installazione, uso, manutenzione e risoluzione di problemi.
I product data validati per le caratteristiche tecniche del prodotto.
Il Knowledge Graph aziendale per relazioni ufficialmente modellate.
Il web per informazioni esterne che l’azienda non possiede.
Non basta quindi attribuire a ogni risultato uno score di similarità.
Serve un vero modello di affidabilità delle fonti.
Quando emergono conflitti, la provenienza, la data di aggiornamento, lo stato di validazione e la gerarchia delle fonti possono contribuire alla loro risoluzione.
Questo rappresenta un passaggio fondamentale verso la knowledge governance.
Il vero cuore dell’architettura: query understanding e orchestration
A questo punto disponiamo di numerose capacità: dense retrieval; lexical o sparse retrieval; exact matching; SQL e API; web grounding; Knowledge Graph; reranking; eventuale caching.
Il rischio sarebbe quello di chiamarle tutte per ogni domanda.
Non sarebbe un’architettura evoluta.
Sarebbe un’architettura costosa e rumorosa.
Serve quindi un livello superiore capace di stabilire quale percorso seguire.
Questo livello può essere definito query router, orchestrator o agentic retrieval layer.
Il suo compito consiste innanzitutto nel comprendere la domanda.
Deve riconoscere intento, entità, eventuali codici, attributi richiesti, riferimenti a prodotti esterni, dipendenze dal contesto conversazionale e possibile necessità di dati aggiornati.
Può inoltre decomporre una domanda complessa in sotto-domande.
Successivamente decide quali strumenti utilizzare e in quale ordine.
Non esiste necessariamente una sequenza identica per ogni richiesta.
Esiste invece una logica universale di orchestrazione: prima comprendere ciò che manca, poi utilizzare soltanto le fonti necessarie per costruire la risposta.
Come cambia il percorso in funzione della domanda
| Domanda dell’utente | Percorso prevalente |
| “Cerco un utensile per lavorare acciaio temprato” | query understanding → hybrid retrieval → reranking |
| “Avete il codice ABC123?” | identity resolution / exact lookup → product data |
| “Qual è il ricambio del prodotto X?” | entity resolution → Knowledge Graph → eventuale document retrieval |
| “Qual è la procedura di calibrazione?” | hybrid document retrieval → reranking |
| “Quanto costa X ed è disponibile?” | identity resolution → SQL/API |
| “Avete qualcosa di equivalente al prodotto X del produttore Y?” | verifica fonti interne → eventuale web grounding → normalizzazione caratteristiche → internal retrieval → confronto |
| “Quale accessorio è compatibile con X e adatto a Y?” | entity resolution → Graph RAG → eventuale Vector RAG → context fusion |
Questa tabella mostra un principio fondamentale.
Non è l’LLM a dover sapere tutto. È l’architettura a dover sapere dove trovare ciò che serve.
Quanto deve essere “agentico” il router?
I moderni modelli linguistici possono scegliere autonomamente quali tool utilizzare sulla base della domanda e delle istruzioni ricevute.
Questa capacità è estremamente utile.
Ma in un’applicazione aziendale non significa necessariamente delegare all’LLM ogni decisione.
Esistono scelte che possono essere opportunamente lasciate al modello e altre che conviene codificare come vincoli deterministici.
Per esempio, riconoscere che una domanda richiede una ricerca tecnica può essere una decisione semantica.
Stabilire che dati riservati sul prezzo di uno specifico cliente possano essere recuperati soltanto dopo autenticazione è invece una regola applicativa.
Analogamente, l’LLM può decidere che serva una query SQL, ma non dovrebbe poter costruire e lanciare arbitrariamente qualunque interrogazione sul database aziendale.
Il tool dovrebbe esporre funzioni controllate, con parametri, permessi e output definiti.
L’approccio più robusto è quindi spesso ibrido anche nell’orchestrazione: capacità decisionale del modello all’interno di confini deterministici stabiliti dall’applicazione.
Costruire il context window: evidence assembly
Dopo il retrieval rimane ancora un problema.
Il context window dell’LLM potrebbe contenere: passaggi recuperati tramite dense search;
contenuti recuperati lessicalmente; relazioni provenienti dal Knowledge Graph; valori SQL;
product data; informazioni ottenute tramite grounding esterno; metadati e provenienza.
Non è sufficiente concatenare tutto.
Serve un livello di evidence assembly.
Il sistema deve selezionare le evidenze necessarie, eliminare duplicazioni, preservare la provenienza, individuare eventuali contraddizioni e attribuire priorità alle fonti.
Solo successivamente costruisce il contesto utilizzato dal modello per formulare la risposta.
Questo consente di comprendere meglio anche il vero ruolo del reranking.
Il reranker è uno degli strumenti disponibili per migliorare il context assembly, ma non sostituisce la governance.
Uno score elevato di pertinenza semantica non rende automaticamente una fonte più aggiornata, più affidabile o più autorevole.
Il context window non contiene soltanto “chunk”
Una delle semplificazioni più comuni del RAG consiste nel pensare al context window come a una raccolta di frammenti testuali.
In un chatbot tecnico evoluto il contesto può invece essere eterogeneo.
Una parte può contenere testo.
Una parte fatti strutturati.
Una parte relazioni.
Una parte metadati.
Una parte vincoli.
L’LLM riceve quindi una sorta di evidence package costruito appositamente per quella domanda.
L’obiettivo non è recuperare il maggior numero possibile di informazioni, è recuperare il minimo insieme di informazioni sufficienti, pertinenti, affidabili e aggiornate per formulare la risposta.
Questa è una differenza architetturale sostanziale.
Cache-Augmented Generation: quando non conviene recuperare ogni volta lo stesso contesto
Esiste infine un’altra situazione.
Supponiamo che un chatbot riceva moltissime domande relative allo stesso insieme di documenti relativamente stabile. Per esempio: condizioni di vendita; policy sui resi; documentazione di un modello di macchina molto diffuso; un manuale frequentemente interrogato; procedure aziendali utilizzate da numerosi utenti.
In questi casi può essere poco efficiente ripetere continuamente lo stesso ciclo di ingestione del contesto.
La Cache Augmented Generation, o più in generale l’utilizzo di meccanismi di context caching, introduce un principio differente.
Una porzione relativamente stabile e frequentemente riutilizzata del contesto viene preparata e mantenuta in cache in modo che richieste successive possano riutilizzare parte dell’elaborazione già effettuata.
Anthony Tinline, in CAG + RAG Architecture for AI Engineers, affronta proprio la combinazione fra caching, retrieval ibrido, reranking e context assembly.
Il punto importante è che Cache Augmented Generation e RAG non devono essere considerati tecniche alternative. Possono essere complementari.
Cache Augmented Generation non significa “domande uguali”
Il criterio interessante non è soltanto che molti utenti pongano la stessa domanda.
È sufficiente che molte domande utilizzino la stessa porzione di conoscenza.
“Entro quanto posso effettuare il reso?”
“Chi paga la spedizione del reso?”
“Come riceverò il rimborso?”
“Posso restituire un articolo aperto?”
Sono domande differenti.
Ma potrebbero dipendere tutte dallo stesso documento sulle condizioni di reso.
Quella porzione di contesto può quindi diventare un buon candidato al caching.
Il vantaggio riguarda soprattutto la riduzione dell’elaborazione ripetuta del medesimo prefisso o contesto e, a seconda dell’implementazione, una riduzione di latenza e costi.
Il modello di pricing e la durata della cache dipendono dalla tecnologia utilizzata: per esempio si paga di più lo storage orario e molto meno l’elaborazione dei token.
La cache non è una memoria aziendale onnisciente
È altrettanto importante non trasformare il caching in una sorta di “memoria magica”.
La cache è un’ottimizzazione.
Non sostituisce la governance delle fonti.
Non rende un documento più aggiornato.
Non risolve eventuali contraddizioni.
Non elimina i limiti del context window.
E soprattutto non rende conveniente precaricare indiscriminatamente l’intero patrimonio documentale di un’azienda.
In presenza di migliaia o milioni di documenti, rimane necessario selezionare quale conoscenza sia pertinente.
Può quindi essere particolarmente interessante un’architettura dinamica in cui il router identifica l’insieme di documenti necessario e il sistema verifica se esso sia già disponibile in cache.
Se lo è, lo riutilizza.
Se non lo è, prepara il nuovo contesto.
La Cache Augmented Generation diventa così una ottimizzazione del retrieval e del context management, non un sostituto universale del retrieval.
RAG, Graph RAG, SQL e Cache Augmented Generation risolvono problemi diversi
A questo punto è possibile vedere con maggiore chiarezza l’intera architettura.
La ricerca vettoriale risponde soprattutto al problema:
“Quale contenuto parla di ciò che l’utente intende?”
La ricerca lessicale:
“Quale contenuto contiene precisamente i termini rilevanti?”
L’exact matching:
“Quale entità è esattamente quella indicata?”
Il Knowledge Graph:
“Quali relazioni esplicite collegano questa entità alle altre?”
SQL e API:
“Qual è il valore strutturato e aggiornato presente nella source of truth?”
Il web grounding:
“Quale informazione esterna manca per poter formulare correttamente la ricerca interna?”
La Cache Augmented Generation:
“Quale contesto stabile e ricorrente conviene non rielaborare completamente a ogni richiesta?”
Sono domande diverse.
Ed è precisamente per questo che queste tecniche possono cooperare.
Una possibile architettura complessiva
La pipeline può essere rappresentata concettualmente così:
Domanda dell’utente
↓
Query understanding
Il sistema identifica intento, entità, codici, attributi, riferimenti esterni, necessità di dati aggiornati e dipendenze dal contesto conversazionale.
↓
Query routing / orchestration
Viene stabilito quali fonti e quali strumenti siano necessari.
↓
Eventuale knowledge enrichment
Se per comprendere un’entità esterna mancano informazioni interne, viene effettuato grounding esterno.
↓
Retrieval
Possono essere attivati, singolarmente o in combinazione, dense retrieval, lexical/sparse retrieval, exact lookup, Knowledge Graph e SQL/API.
↓
Rank fusion e reranking
Applicati soltanto alle evidenze per cui il ranking di pertinenza è realmente significativo.
↓
Evidence assembly
Deduplicazione, provenance, controllo delle contraddizioni, gerarchia delle fonti, selezione del contesto.
↓
Context window
L’LLM riceve l’insieme ottimizzato delle evidenze.
↓
Generation
Il modello formula una risposta coerente con le informazioni recuperate e con le regole applicative.
↓
Rendering applicativo
Eventuali dati strutturati possono essere utilizzati dal front-end per generare schede prodotto, link, tabelle, azioni o altri elementi dell’interfaccia.
La Cache Augmented Generation può intervenire trasversalmente, permettendo di riutilizzare porzioni di contesto particolarmente stabili e frequentemente consultate.
La risposta dell’LLM è l’ultimo anello, non il primo
Questa architettura porta a una conclusione importante.
Il valore di un chatbot tecnico non dipende soltanto dalla qualità del Large Language Model utilizzato.
Dipende in misura enorme da ciò che accade prima della generazione.
Quale entità è stata riconosciuta?
Quali fonti sono state interrogate?
Quale relazione è stata seguita?
Quanto sono aggiornati i dati?
Da dove deriva una determinata affermazione?
Sono state trovate informazioni contraddittorie?
Quale fonte ha prevalso e perché?
Quali evidenze sono state effettivamente fornite al modello?
L’LLM può formulare molto bene una risposta sbagliata se riceve il contesto sbagliato.
Per questo il problema fondamentale delle applicazioni tecniche non è soltanto la generazione.
È l’ingegneria del contesto.
La distinzione fra “sapere” e “parlare”
Questo consente anche di separare due capacità che vengono spesso confuse.
Il modello linguistico è molto bravo a parlare della conoscenza.
L’architettura deve essere molto brava a trovare la conoscenza giusta.
Affidabilità significa evitare che il primo compito supplisca arbitrariamente alle carenze del secondo.
Se un dato non è presente nelle fonti disponibili, il sistema deve saperlo riconoscere.
Se una relazione non è stata validata, non dovrebbe essere presentata come certa.
Se una disponibilità non è stata interrogata nel sistema aggiornato, non dovrebbe essere dedotta da un vecchio documento.
Se un’equivalenza fra prodotti è soltanto probabile, deve essere distinta da una equivalenza ufficialmente censita.
Questa separazione fra retrieval ed espressione linguistica è una delle condizioni necessarie per utilizzare l’AI in contesti tecnici professionali.
Dal chatbot al sistema di accesso alla conoscenza aziendale
Visto da questa prospettiva, il chatbot diventa qualcosa di più interessante di una semplice interfaccia conversazionale.
Diventa un livello intelligente di accesso alle diverse forme di conoscenza aziendale.
Documentazione testuale.
Product data.
Relazioni fra entità.
Dati transazionali.
Conoscenza esterna.
Regole applicative.
Contesto conversazionale.
Il linguaggio naturale diventa il punto di accesso comune.
Ma dietro l’interfaccia non esiste un unico grande contenitore di dati.
Esiste un’architettura capace di mantenere distinte fonti che hanno caratteristiche, frequenze di aggiornamento e livelli di affidabilità differenti.
Ed è proprio questa separazione a rendere possibile combinarle in modo controllato.
Un principio progettuale: portare ogni domanda alla fonte migliore
Per chi deve decidere come sviluppare un chatbot tecnico, il principio più importante può essere quindi formulato in modo molto semplice: non chiediamoci soltanto quale modello utilizzare. Chiediamoci quale fonte dovrebbe poter rispondere a ciascun tipo di domanda.
Da qui discendono molte decisioni architetturali.
Se il problema è comprendere un bisogno espresso in linguaggio naturale, serve semantic search.
Se è riconoscere termini specifici, serve lexical retrieval.
Se è identificare un codice, serve exact lookup.
Se è conoscere un valore corrente, serve la fonte transazionale.
Se è percorrere una relazione, serve conoscenza strutturata.
Se manca una informazione esterna, serve web grounding.
Se lo stesso contesto stabile viene utilizzato continuamente, può essere opportuno valutarne il caching.
Il router deve successivamente mettere queste capacità a disposizione dell’applicazione e scegliere il percorso appropriato.
La qualità dei dati rimane il prerequisito
Naturalmente nessuna architettura può compensare completamente dati e contenuti di cattiva qualità.
La dense search non corregge automaticamente una descrizione prodotto errata.
Il Knowledge Graph non rende vera una relazione soltanto perché essa è stata trasformata in un arco.
SQL restituisce con grande precisione anche un valore sbagliato se il database contiene un valore sbagliato.
Il web grounding può recuperare informazioni pubbliche incomplete.
Per il Knowledge Graph sono quindi essenziali normalizzazione, deduplicazione, canonizzazione delle entità, entity linking, provenance e validazione.
Per il corpus documentale sono importanti qualità dei documenti, segmentazione, metadati, versioning e corretta associazione fra contenuti ed entità.
Per i database operativi servono ownership e processi di aggiornamento.
L’AI non elimina la data governance, la rende ancora più importante.
Anche i metadati fanno retrieval
Un ulteriore elemento spesso sottovalutato è il filtraggio tramite metadati.
Supponiamo che la domanda riguardi un particolare modello di macchina, una lingua, una versione di firmware o la revisione più recente di un manuale.
Non sempre la soluzione migliore consiste nel lasciare che l’embedding distingua semanticamente tutti questi elementi.
È spesso preferibile restringere preventivamente il dominio di ricerca:
modello = X;
lingua = italiano;
revisione = corrente;
tipo_documento = manuale_operatore.
La semantic search viene quindi applicata all’interno dell’insieme corretto di documenti.
I metadati introducono così una forma di precisione deterministica prima ancora del ranking semantico.
In molte applicazioni industriali rappresentano uno degli strumenti più efficaci per migliorare la qualità del RAG.
Retrieval non significa sempre ricerca
Arrivati a questo punto emerge un cambiamento anche terminologico.
Parlare genericamente di “motore di ricerca del chatbot” rischia di essere riduttivo.
Alcune informazioni vengono effettivamente cercate.
Altre vengono calcolate.
Altre vengono attraversate nel grafo.
Altre vengono interrogate in SQL.
Altre sono già nel contesto.
Altre vengono acquisite dall’esterno.
È quindi più corretto pensare a un knowledge access layer.
Un livello che traduce l’intento dell’utente nell’insieme di operazioni necessarie per recuperare evidenze affidabili.
Come valutare la qualità di un sistema di questo tipo
Anche le metriche devono evolvere.
Non basta chiedersi se l’LLM “risponde bene”.
Occorre misurare separatamente diverse componenti.
Il router ha selezionato lo strumento corretto?
Il retrieval ha recuperato le fonti necessarie?
Il reranking ha promosso quelle più rilevanti?
L’entity resolution ha individuato il codice corretto?
Il grafo ha percorso le relazioni appropriate?
I dati SQL erano aggiornati?
Il sistema ha rispettato la gerarchia delle fonti?
La risposta finale è supportata dalle evidenze recuperate?
La provenance consente di ricostruire l’origine delle affermazioni?
Solo separando queste dimensioni è possibile capire dove intervenire quando la risposta non è soddisfacente.
Un sistema complesso deve essere anche osservabile.
Il Knowledge Graph può aiutare anche oltre il retrieval
Esiste infine una prospettiva ancora più ampia.
Andrew Bar, in Engineering Knowledge Graphs for LLM Applications, evidenzia come un grafo possa diventare non soltanto una fonte di conoscenza per il chatbot, ma anche uno strumento per rappresentare vincoli, dipendenze, metadati e percorsi logici utili ad applicazioni agentiche.
Il grafo può quindi contribuire a descrivere non soltanto il dominio tecnico, ma anche parte delle regole che governano il comportamento dell’applicazione.
Questo apre la strada a sistemi in cui entità, relazioni, provenance e regole aziendali contribuiscono a rendere più controllabile l’azione degli agenti AI.
È un’evoluzione importante: dalla Graph RAG utilizzata per recuperare informazioni a una vera knowledge architecture a supporto del ragionamento e dell’orchestrazione.
Il punto di arrivo: un’architettura composita, non un RAG sempre più grande
La tentazione potrebbe essere quella di migliorare continuamente la RAG aumentando il numero di documenti, la dimensione degli embedding, il numero dei risultati recuperati o il context window.
Ma il salto qualitativo più importante avviene quando si smette di chiedere a un unico meccanismo di retrieval di risolvere problemi diversi.
Un chatbot tecnico evoluto può essere costruito come un sistema composito.
La ricerca semantica comprende significati.
La ricerca lessicale preserva precisione terminologica.
L’exact matching identifica codici ed entità.
Il Knowledge Graph esplicita relazioni e permette di seguirne le catene.
SQL e API recuperano dati vivi dalle fonti transazionali.
Il web grounding colma, quando necessario, lacune informative esterne.
La CAG ottimizza la gestione di contesti stabili e frequentemente riutilizzati.
L’orchestrator decide quali di questi meccanismi utilizzare.
L’evidence assembly costruisce il contesto finale.
L’LLM formula la risposta.
È una distinzione fondamentale.
L’LLM non è la conoscenza aziendale. È il componente che comprende la richiesta e trasforma in linguaggio le evidenze che l’architettura è riuscita a raccogliere.
Più quelle evidenze sono pertinenti, aggiornate, strutturate, tracciabili e coerenti con la domanda, maggiore sarà l’affidabilità della risposta.
La vera evoluzione dei chatbot tecnici passa quindi da una domanda molto concreta:
non “quanto è intelligente il modello?”, ma “quanto è intelligente il sistema con cui gli permettiamo di accedere alla conoscenza?”
Letture consigliate
Anthony Tinline, CAG + RAG Architecture for AI Engineers: Design Fast, Reliable Retrieval Workflows with Hybrid Search, Re-Ranking, and Resilient Context Assembly, 2026.
Andrew Bar, Engineering Knowledge Graphs for LLM Applications: Schema Design, Ontologies, RAG Pipelines, Graph Databases, and Context-Aware AI Systems, 2026.
Michael Trevd, The Complete Graph RAG Handbook: Master Knowledge Graphs, Vector Search, Hybrid Retrieval, LLMs, Context Engineering, and Production-Ready AI Systems, 2026.
Thomas Frisendal, Graph Data Modeling for NoSQL and SQL: Visualize Structure and Meaning, Technics Publications, 2016.